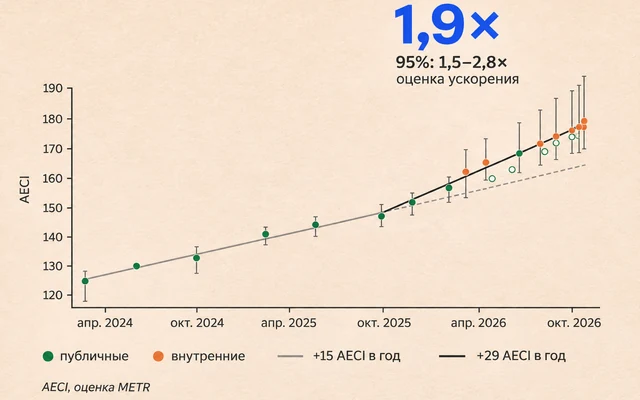
Команда Claude Code, инструмента Anthropic для программирования, 16 ноября сообщила, что Claude пишет и проверяет около 90% её кода. Во внутреннем тесте отдельный проверяющий оценивал результат по заданным критериям и повысил успешность генерации структурированных файлов на величину до 10 пунктов по сравнению со стандартным циклом промптинга. Наибольший эффект компания зафиксировала на самых сложных заданиях.
Главным ограничением для масштабирования Anthropic называет проверку результата. Если разработчик должен самостоятельно изучать каждое изменение, он может контролировать только одну или две сессии Claude. Автоматические циклы проверки позволяют запускать десятки или сотни агентов параллельно: каждый получает тест, спецификацию или другой измеримый критерий и может исправлять работу по результатам прогона.
Команда выделяет три особенно полезных вида тестов. Сквозные воспроизводят полный пользовательский сценарий — например, добавление товара в корзину и оплату. Тесты свойств генерируют множество входных данных и ищут нарушение обязательных правил, таких как запрет отрицательного баланса. Дифференциальные тесты подают одинаковые данные старой и новой системам и отмечают неожиданные различия.
Читайте также
Claude также может запускать приложение целиком и проверять его в браузере, симуляторе смартфона или локальной среде. При этом Anthropic предупреждает: нестабильные тесты приучают агента повторять прогон вместо исправления ошибки, а слишком медленные сокращают число проверок.
Описанный подход уже применяется при ревью Claude Code. Как пишет InfoQ со ссылкой на Anthropic, с июня по сентябрь число принятых изменений более чем удвоилось, а доля откатов сократилась более чем на 40%. После одного цикла проверки и исправления стали проходить 78% изменений против 65% ранее. Архитектурные решения, направление продукта и правки с высоким риском остаются за людьми.
Это внутренний кейс Anthropic, поэтому его результаты нельзя автоматически переносить на другие команды и задачи. Практический принцип состоит в том, чтобы до массового запуска кодовых агентов превратить критерии готовности в исполняемые тесты и полноценные пользовательские сценарии, а не полагаться на отчёт самого агента.
Claude и его API напрямую из России не работают, а российские карты для оплаты не подходят. Доступ возможен через посредника или зарубежное юрлицо; альтернативой служат открытые модели на собственных серверах или в российском облаке, а также GigaChat и YandexGPT.