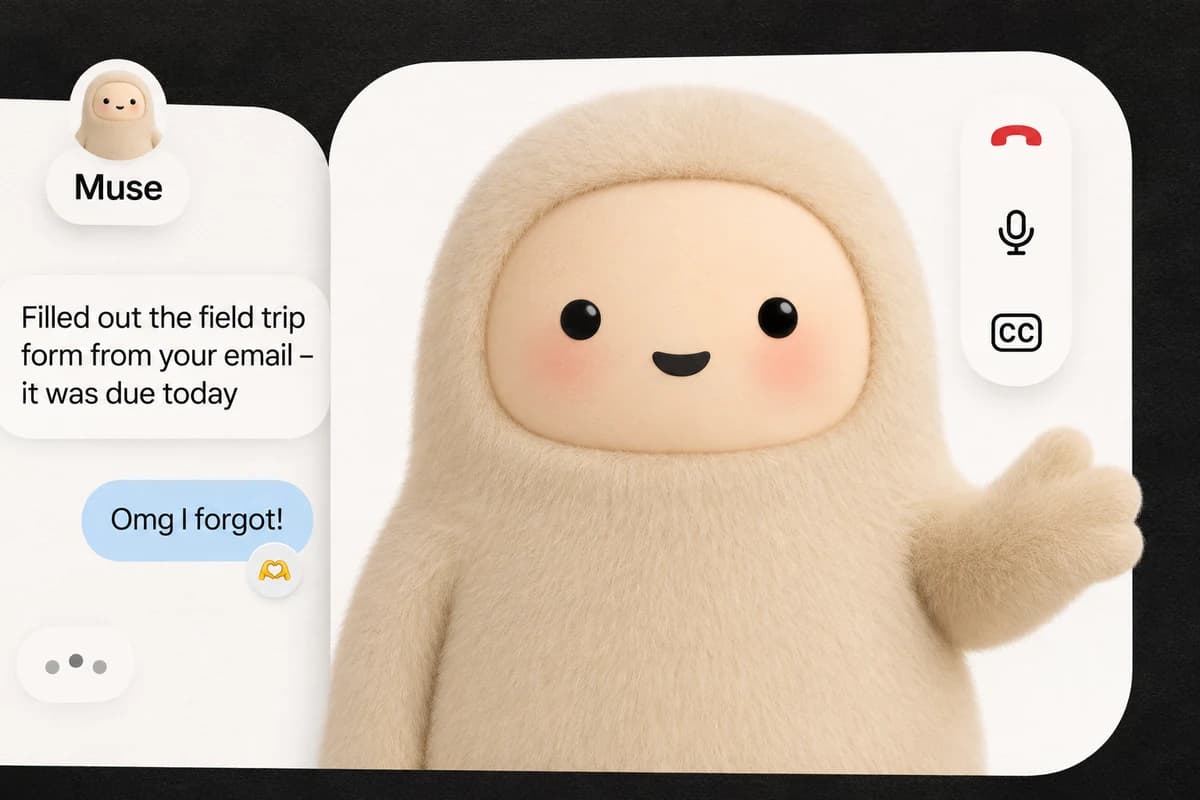
Meta Platforms Inc.* 5 ноября открыла разговоры с анимированным аватаром всем пользователям своего потребительского ИИ-агента Muse в США. Ранее эту возможность показывали на конференции Connect в сентябре.
Muse Voice добавляет к голосовому диалогу генерируемого персонажа. Пока агент отвечает, аватар использует выражения лица и жесты, соответствующие тону разговора. Базового персонажа по прозвищу Jolly можно изменить, придав ему облик человека, животного или другого существа.
В отличие от двустороннего видеозвонка, Muse не получает изображение пользователя. Агент слышит его речь и на ее основе формирует ответ и визуальную реакцию персонажа. Функция работает на мобильных устройствах, в браузере и на Mac. В дальнейшем компания намерена добавить голосовые разговоры в свои очки с ИИ и готовящееся устройство Muse Charm с небольшим экраном.
Читайте также
В техническом описании, опубликованном 23 сентября, разработчики объяснили, что голос и движения формируются в одной потоковой системе. Muse Realtime Voice создает речь, а Muse Realtime Avatar использует тот же поток данных, чтобы синхронизировать голос, движения губ и мимику. По измерениям компании, первый фрагмент ответа поступает примерно через 870 миллисекунд после окончания реплики пользователя, то есть менее чем за секунду.
Muse отличается от обычных голосовых режимов ChatGPT и других ассистентов визуальным воплощением агента. Компания рассчитывает, что настраиваемый персонаж с мимикой и жестами усилит эмоциональную связь пользователя с Muse.
Пока запуск охватывает только США.
* Деятельность Meta признана экстремистской и запрещена в РФ