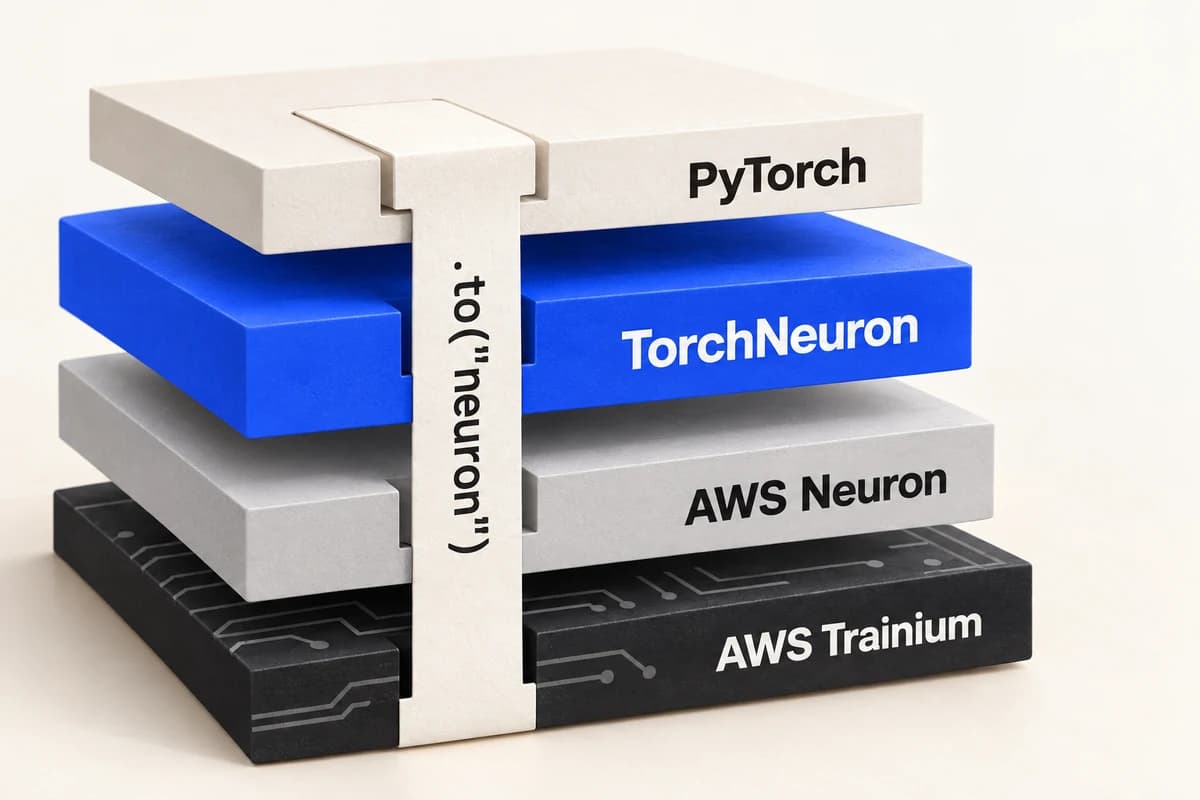
AWS представила TorchNeuron — открытый программный бэкенд, который подключает облачные ИИ-ускорители Trainium к PyTorch как стандартное устройство. Публичная бета выйдет 20 октября 2026 года под лицензией Apache 2.0 и будет работать с Trainium2 и Trainium3.
Чтобы перенести совместимую модель на Trainium, достаточно указать устройство neuron. Приложения, использующие стандартный интерфейс PyTorch torch.accelerator, смогут работать без изменений в модельном коде. Для повышения производительности доступен torch.compile; привычные инструменты PyTorch для отладки, распределённого обучения и профилирования также работают с новым бэкендом.
Интеграция уже добавлена в библиотеки Hugging Face для языковых моделей, генерации изображений и обучения нейросетей. По замерам Hugging Face, без дополнительной адаптации работают архитектуры 89 из 100 наиболее используемых моделей генерации текста. У прежнего решения Optimum Neuron 0.4.5 этот показатель составлял 46 из 100. После обучения сохраняется стандартная контрольная точка модели, которую можно загрузить на другом оборудовании.
Читайте также
TorchNeuron даёт разработчикам альтернативу связке ускорителей Nvidia и CUDA: совместимые PyTorch-приложения можно проверить на Trainium без переписывания модельного кода и перехода на отдельный набор инструментов. Аналогичный механизм PyTorch уже применяется для ускорителей AMD и чипов Apple.
Перенос без доработок гарантирован не всем моделям: при использовании неподдерживаемых функций код придётся менять. Режим torch.compile требует фиксированных форм входных данных и заново компилирует модель для каждой новой формы. Первый запуск крупной модели также может занять заметное время, а 64-битные числа с плавающей точкой обрабатываются как 32-битные, что способно повлиять на точность вычислений.
Вычисления на Trainium доступны через инфраструктуру AWS, которая не принимает новых клиентов из России.