17 ноября Microsoft вывела в общий доступ Decision-1.1 — модель, которая не пишет развёрнутый ответ, а выбирает действие из заданных вариантов. По данным компании, её уже использовали более 4000 клиентов, в том числе для маршрутизации запросов, разметки данных, персонализации и фильтрации контента. В тот же день TechCrunch сообщил, что в октябре на модели этого класса пришлось больше четверти запросов через маршрутизатор Vercel.
Это признак более широкого изменения корпоративной архитектуры ИИ. Вместо одной дорогой универсальной модели компании могут поставить перед несколькими моделями маршрутизатор: он оценивает запрос, его стоимость и сложность, а затем выбирает подходящего исполнителя. Такой подход способен заметно сократить расходы на повторяемых задачах, но экономия появляется только после проверки на собственных данных.
Что происходит: одна модель перестаёт быть ответом на все задачи
Универсальная модель удобна на старте: приложение отправляет ей любой запрос и получает текст, код или структурированный ответ. Но для многих производственных операций такая гибкость избыточна. Системе поддержки часто нужно лишь определить тему обращения, выбрать очередь и оценить срочность. Антифрод-системе — пропустить операцию или передать её на проверку. Корпоративному помощнику — решить, какой инструмент вызвать.
Читайте также
Для таких сценариев появились decision-модели. Они выбирают один вариант из заранее заданного набора и возвращают оценку уверенности, не расходуя ресурсы на длинное объяснение. Microsoft описывает Decision-1.1 как модель для маршрутизации, разметки, персонализации и фильтрации. Компания также сообщила о мультимодальной поддержке и росте скорости и точности, но не раскрыла на открытой странице универсальную таблицу результатов, позволяющую независимо сравнить модель со всеми конкурентами.
Одновременно разработчики разделяют и генеративные модели по цене и назначению. 17 ноября OpenAI выпустила GPT-6.2 Astra для наиболее сложных проектов и более доступную GPT-6.2 Sol для повседневного письма и программирования. Это не означает, что одна модель всегда лучше другой: выбор зависит от задачи, требуемой точности и цены ошибки.
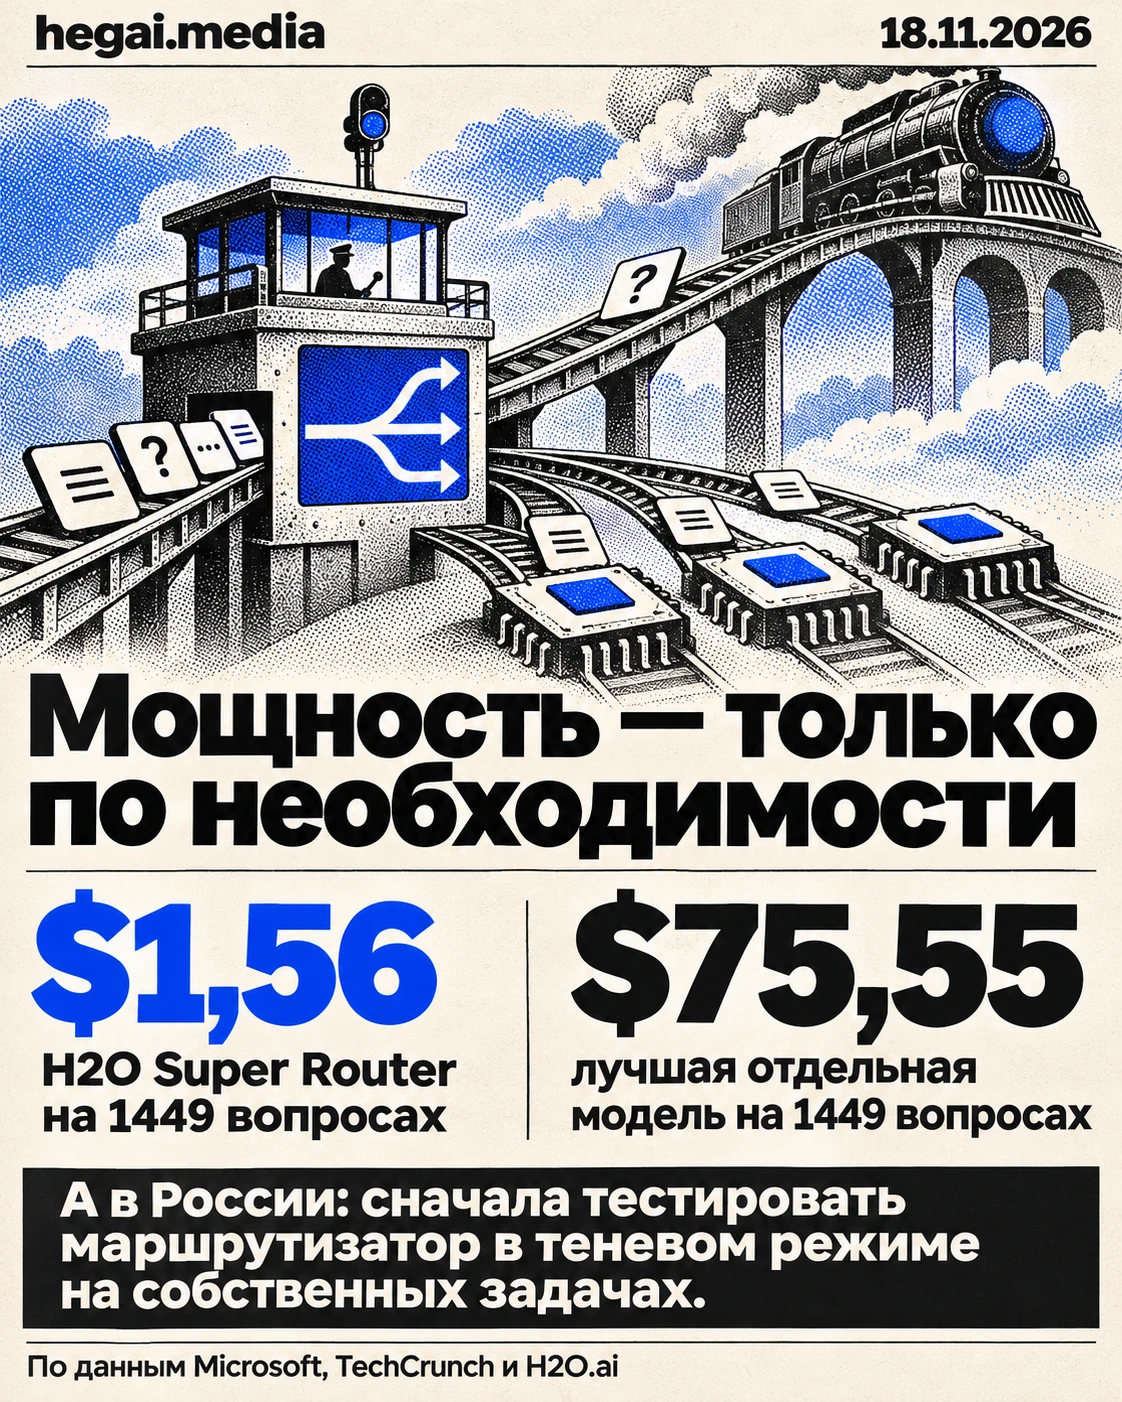
Идея маршрутизации появилась не вчера. 28 октября H2O.ai представила предварительную версию Super Router, который читает запрос, оценивает вероятность правильного ответа и цену каждой доступной модели, а затем выбирает подходящее соотношение качества и стоимости. Новый факт ноября в том, что отдельный класс decision-моделей уже получил заметную долю реального потока запросов, а Microsoft вывела собственную модель в общий доступ.
Как устроен маршрутизатор моделей
Маршрутизатор находится между приложением и моделями. Сначала он получает запрос пользователя или системы, затем оценивает его тип и выбирает маршрут. Простейшие правила можно записать вручную: например, документы определённого вида направлять локальной модели, программный код — модели для разработки, а неоднозначные запросы — наиболее сильной универсальной модели.
Более сложный маршрутизатор сам прогнозирует, какая модель с наибольшей вероятностью даст приемлемый ответ. При этом учитываются как минимум четыре параметра:
- Качество. Достаточно ли модель точна именно на запросах компании.
- Стоимость. Сколько стоит обработка входного текста и создание результата.
- Задержка. Укладывается ли ответ в требования продукта.
- Уверенность. Нужно ли передать сомнительный результат более сильной модели или человеку.
Рабочий конвейер может выглядеть так: decision-модель определяет категорию обращения; специализированная модель выполняет типовую операцию; универсальная модель разбирает редкие и неоднозначные случаи; программные правила или человек проверяют критические решения.
Маршрутизатор не обязан быть нейросетью. На первом этапе эту роль могут выполнять обычные правила и ограничения бюджета. Обучаемая система становится полезна, когда запросов много, категории пересекаются, а заранее описать все случаи невозможно.
Главная опасность — ошибочная маршрутизация. Дешёвая модель может получить задачу, для которой ей не хватает знаний или контекста, но сформировать убедительный результат. Поэтому системе нужен путь эскалации: низкая уверенность, нарушение формата или неудачная автоматическая проверка должны переводить запрос на более сильную модель либо человеку.
Что показывают цифры и почему их нельзя переносить на любой бизнес
Публичные эксперименты подтверждают потенциальную экономию, но каждый измеряет собственный сценарий.
| Система или эксперимент | Проверенная задача | Заявленный результат | Существенное ограничение |
|---|---|---|---|
| Microsoft Decision-1.1 | Выбор действия, маршрутизация, разметка и фильтрация | Более 4000 клиентов использовали модель, по данным Microsoft | Нет открытого независимого сравнения на задачах конкретной компании |
| Маршрутизатор Vercel | Распределение запросов между моделями | В октябре decision-модели получили больше четверти запросов | Доля трафика не доказывает точность или экономию каждого клиента |
| H2O Super Router | 1449 ранее не показанных вопросов из публичного набора | Та же точность, что у лучшей отдельной модели, при стоимости $1,56 вместо $75,55 | Модели в наборе были примерно годичной давности; на другом тесте маршрутизатор терял до 13,8 процентного пункта |
| Дообученная LLaMA 3.1 8B | Проверка разговоров по 18 полям | 83% общей точности по оценке людей, 100% корректных JSON и 100% на критическом поле | Проверка охватила только 53 ранее не показанные производственные записи |
Эксперимент с LLaMA 3.1 8B особенно хорошо показывает смысл специализации. Исследователи дообучили небольшую модель всего на 219 примерах, меняя через LoRA 2,05% параметров, и добавили детерминированный программный слой. На одной NVIDIA A100 обработка занимала около двух секунд и стоила $0,013 против $0,025–0,055 у закрытых альтернатив.
Это не доказательство, что небольшая модель вдвое или вчетверо дешевле на любой задаче. Результат относится к узкой проверке разговоров, конкретным данным и выбранным поставщикам. Но он демонстрирует принцип: если выходной формат и критерии правильности заранее известны, общая эрудиция крупнейшей модели может не окупать свою цену.
Тот же предел виден в испытании H2O.ai. На основном наборе маршрутизатор достиг точности лучшей модели при 1/48 её стоимости. Однако на тесте, распределение которого отличалось от обучающих данных, результат ухудшился на величину до 13,8 процентного пункта. Разработчик прямо советует переобучать маршрутизатор на собственном потоке.
Кто выигрывает и кто платит за усложнение системы
Больше всего выигрывают продукты с большим числом похожих операций: поддержка, модерация, сортировка документов, поиск, типовые изменения кода и обработка заявок. Даже небольшая экономия на одном запросе становится заметной, если приложение выполняет миллионы вызовов, а ИИ-агент обращается к моделям несколько раз для одной пользовательской задачи.
Пользу получают и компании с жёсткими требованиями к задержке. Если decision-модель быстро выбирает действие, пользователю не приходится ждать, пока универсальная модель сформирует длинное рассуждение. Для операций с персональными или коммерчески чувствительными данными отдельные маршруты также позволяют оставить часть обработки внутри инфраструктуры компании.
За это приходится платить инженерной сложностью. Команде нужны:
- набор реальных запросов и эталонных ответов;
- отдельные метрики для каждого маршрута;
- контроль стоимости и задержки;
- журнал решений маршрутизатора;
- механизм повторного запуска на более сильной модели;
- регулярная проверка после обновления моделей и изменения пользовательского потока.
Поставщики моделей выигрывают, если удерживают внутри своей платформы сразу несколько классов нагрузки. Клиенту в таком случае проще переключаться между моделями, но возникает зависимость от форматов, цен и инструментов одного облака. Независимый маршрутизатор уменьшает эту зависимость, хотя добавляет ещё один компонент, который нужно разворачивать, контролировать и защищать.
Универсальная модель при этом не исчезает. Она остаётся страховкой для редких задач, новых сценариев и запросов, которые требуют сочетания разных навыков. Рациональная цель — не заменить самую сильную модель любой ценой, а сократить число случаев, когда её мощность оплачивается без необходимости.
Что это меняет для компаний в России
Для российской компании практический вывод не сводится к выбору между конкретными американскими моделями. Архитектуру можно собрать из доступных облачных, открытых и локально развёрнутых моделей, если их разрешают требования к данным и инфраструктуре. Ключевой актив здесь — не название поставщика, а собственный набор задач с известными правильными результатами.
Начинать безопаснее с наблюдения, а не с автоматического переключения. Маршрутизатор можно запустить в теневом режиме: он будет предлагать модель, но реальный запрос продолжит выполнять действующая система. Затем команда сравнит качество, цену и задержку и только после этого переведёт часть нагрузки на новый маршрут.
Для регулируемых процессов нужно отдельно определить, какие данные разрешено передавать внешним провайдерам и где хранится журнал запросов. Локальная небольшая модель может снизить объём передаваемых данных, но сам факт локального запуска не гарантирует качество или соответствие требованиям.
Экономику следует считать на полном цикле. Цена токенов — лишь одна статья расходов. К ней добавляются разработка маршрутизатора, подготовка примеров, вычисления для локальных моделей, мониторинг, повторная обработка ошибок и проверка человеком. При небольшом потоке такая инфраструктура может стоить дороже, чем прямое использование одной модели.
- Исследователи показали небольшую модель для проверки разговоров, дообученную на 219 примерах
- OpenAI представила Astra for Law с юридическим индексом и специальными инструкциями
- Decision-модели получили больше четверти запросов через маршрутизатор Vercel
- OpenAI выпустила GPT-6.2 Astra и Sol, Microsoft расширила линейку специализированных моделейсейчас
- ЗапросПриложение получает письмо, документ, код или команду пользователя
- Decision-модельОпределяет категорию и оценивает уверенность в выборе
- Специализированная модельВыполняет типовую задачу с отраслевыми инструкциями и данными
- Универсальная модельРазбирает сложные и неоднозначные случаи
- ПроверкаПравила, тест или человек подтверждают результат
Вопросы и ответы
- Когда компании нужен маршрутизатор ИИ-моделей?
Когда запросов много, они заметно различаются по сложности, а качество можно измерить на реальных примерах. Для небольшого пилота с редкими и разнообразными задачами одна универсальная модель обычно проще.
- Что такое decision-модель?
Это модель, которая выбирает один из заранее заданных вариантов и оценивает уверенность, вместо того чтобы создавать длинный текст. Её можно использовать для классификации, маршрутизации, фильтрации и выбора следующего действия агента.
- Обязательно ли использовать нейросеть для маршрутизации?
Нет. Первую версию можно построить на правилах: типе документа, длине запроса, языке, допустимом бюджете или категории пользователя. Обучаемый маршрутизатор нужен, когда правила перестают надёжно разделять поток.
- Как проверить, что дешёвая модель действительно выгоднее?
Запустить обе модели на одинаковом наборе реальных задач и сравнить не только цену запроса, но и долю ошибок, задержку, стоимость повторной обработки и проверки человеком. Публичный бенчмарк не заменяет такого испытания.
- Может ли специализированная модель полностью заменить универсальную?
Только в хорошо определённой задаче с проверяемым результатом. Для новых, неоднозначных и редких запросов универсальная модель остаётся запасным маршрутом.
- Как снизить риск неправильной маршрутизации?
Задать порог уверенности, автоматически проверять формат и критические условия, хранить журнал решений и передавать сомнительные случаи более сильной модели или человеку.
- Подходит ли эта архитектура для чувствительных данных?
Может подойти, если маршруты разделены по требованиям к данным, а чувствительная обработка остаётся в допустимом контуре. Но размещение, журналы, доступ сотрудников и условия внешних провайдеров нужно проверять отдельно.