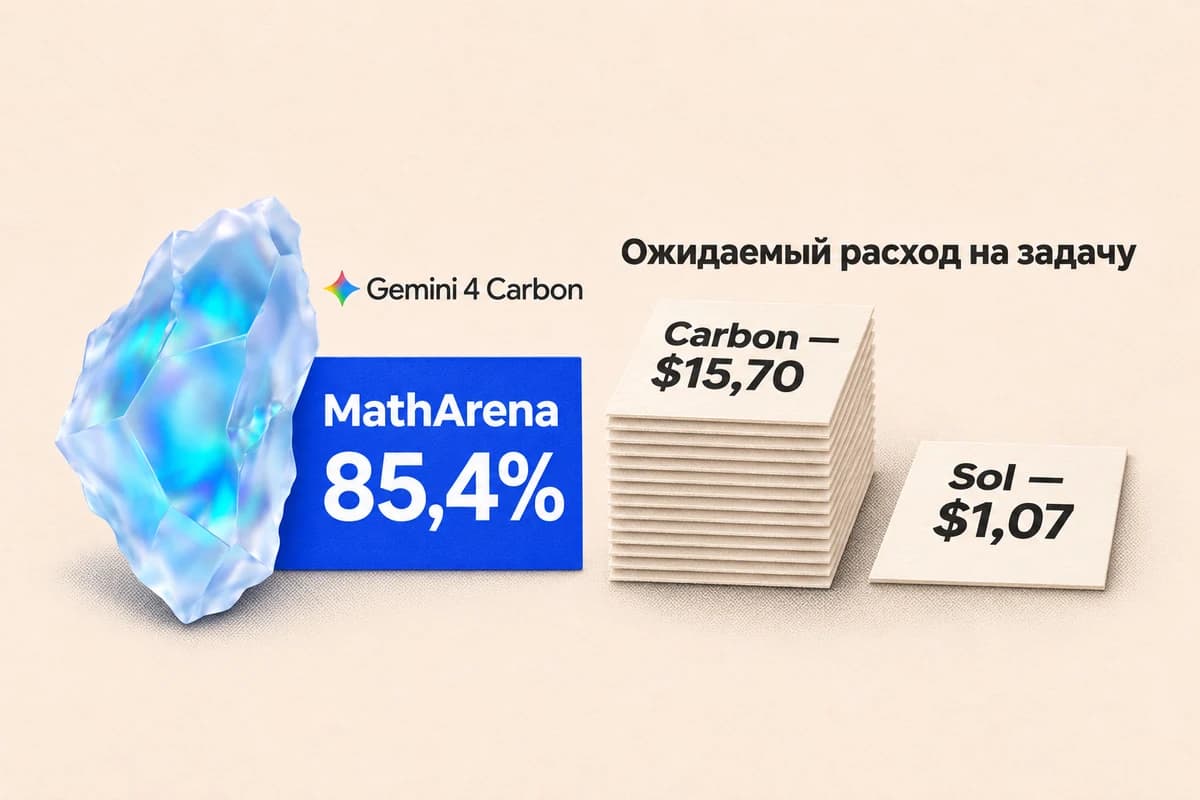
Gemini 4 Carbon заняла первое место в сводном рейтинге MathArena, опередив Claude Fable 5.2 и прежнего лидера GPT-6.1 Sol. Carbon возглавила рейтинг 13 ноября. Google представила модель 28 октября, а 10 ноября расширила платный доступ к ней.
По состоянию на 14 ноября таблица MathArena выглядела так. Это динамический рейтинг: результаты могут меняться по мере появления новых запусков и ротации наборов задач.
| Модель | Компания | Ожидаемый результат |
|---|---|---|
| Gemini 4 Carbon (high) | 85,4% ± 3,0% | |
| Claude Fable 5.2 (max) | Anthropic | 82,8% ± 5,3% |
| GPT-6.1 Sol (max) | OpenAI | 80,6% ± 2,7% |
| Kimi K3.1 Pro (max) | Moonshot AI | 54,3% ± 5,8% |
Преимущество Carbon оказалось дорогим. MathArena оценила средние расходы на один запуск задачи в $15,70 для Carbon, $40,20 для Fable 5.2 и $1,07 для Sol. При одинаковой цене токенов Carbon в условиях MathArena потратила на задачу почти в 15 раз больше Sol из-за более длинных вычислений. Занявшая второе место Fable 5.2 обошлась примерно в 38 раз дороже Sol.
Читайте также
Это не прямое сравнение тарифов API. Carbon и Sol тестировали с одинаковой базовой ценой — $2 за миллион входных и $10 за миллион выходных токенов, но в разных агентных средах и с разными настройками. Carbon работала в режиме high через среду Gravity, а Sol — в режиме max через Codex. Рассуждения модели учитываются как выходные токены. Стоимость и результаты включают статистические оценки и сопоставимы только в условиях MathArena.
У Carbon обнаружилось и ограничение по времени. The Decoder пишет, что наиболее частой причиной неудачи модели было превышение лимита и что она почти никогда не прекращала решение самостоятельно.
Результат не доказывает общего превосходства Carbon над конкурентами. MathArena проверяет модели на математических олимпиадных и исследовательских задачах, а Carbon не победила во всех отдельных выпусках: например, в сентябрьском BrokenArXiv первое место сохранила Sol. Кроме того, Fable 5.2 на момент снимка ещё не завершила все включённые серии тестов.
Для разработчиков и компаний практический вывод состоит не только в новом лидере рейтинга. При выборе модели для сложной математики и длительных агентных задач нужно сравнивать качество с расходами на полное выполнение задачи, лимитами времени и поведением запущенных инструментов. Одинаковая цена токена сама по себе не означает одинаковый счёт за результат.