Thinking Machines Lab 20 ноября выпустила Inkling 2 Mini — модель с открытыми весами для локальной работы с текстом и изображениями. Файл с весами занимает около 20 ГБ: разработчик указывает поддержку компьютеров Apple silicon с 32 ГБ общей памяти и более, а для других платформ рекомендует от 32 ГБ видеопамяти.
| Модель | Разработчик | Баллы |
|---|---|---|
| Inkling 2 Mini | Thinking Machines Lab | 20 |
| Qwen3.8 27B | Alibaba | 20 |
| Nanbeige4.3-33B | Nanbeige | 20 |
Источник рейтинга: Artificial Analysis Intelligence Index.
В модели 26,4 млрд параметров, но при обработке каждого токена задействуется только их часть. Inkling 2 Mini относится к типу «смесь экспертов»: на каждом слое она выбирает восемь из 128 специализированных блоков. Разработчик указывает 3,4 млрд активных параметров без повторных проходов и 5,4 млрд активаций с их учётом.
Читайте также
Справка. Thinking Machines Lab. Разработчик моделей семейства Inkling и платформы Tinker для запуска и настройки моделей.
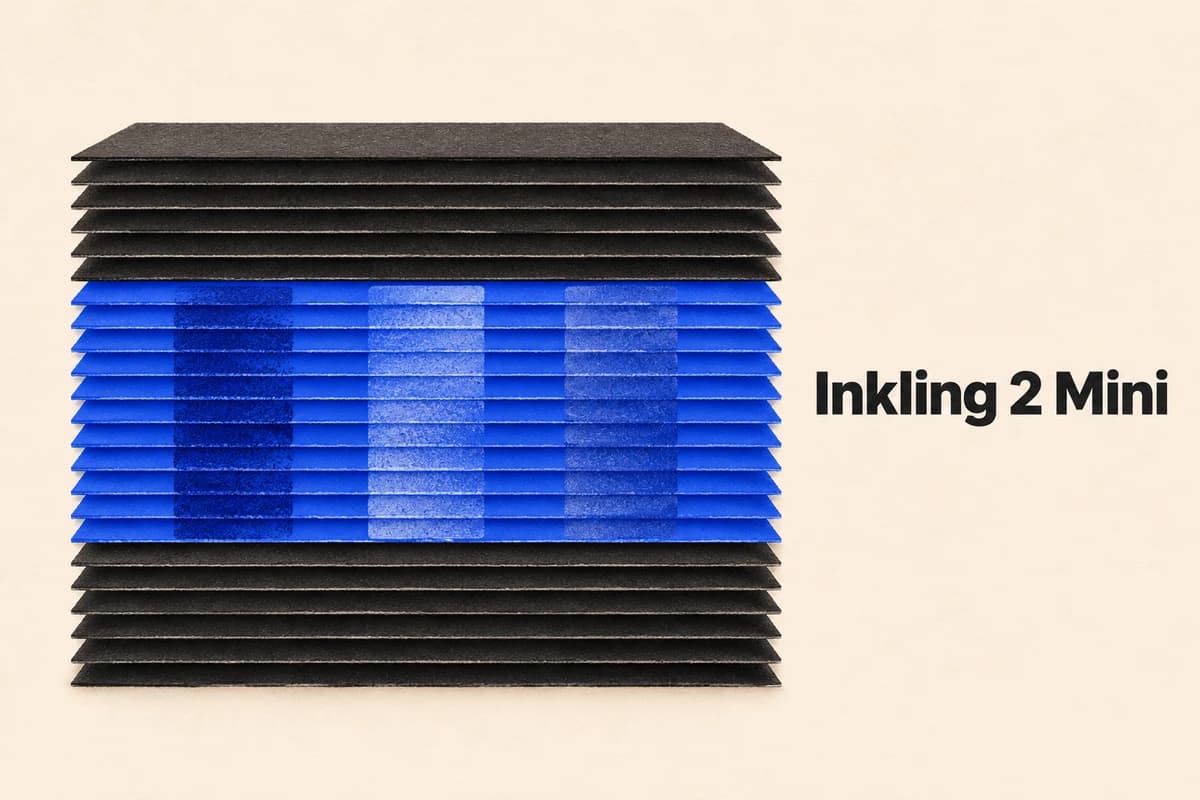
Главное отличие Inkling 2 Mini — повторное использование средних слоёв. У модели 24 физических слоя: первые и последние шесть выполняются один раз, а 12 слоёв между ними — трижды с общими весами. В итоге на каждый токен приходится 48 применений слоя. Между проходами передаются промежуточные результаты, а обучаемый контроллер определяет, какую их часть использовать при следующем вычислении.
Thinking Machines утверждает, что такая петля позволяет дольше рассуждать внутри модели и реже записывать промежуточные шаги в ответ. Это заявление разработчика, а не общее преимущество, подтверждённое для всех задач. Независимый сервис Artificial Analysis присвоил модели 20 баллов в своём Intelligence Index — столько же, сколько Qwen3.8 27B и Nanbeige4.3-33B. В этом тесте Inkling использовала примерно на 38% больше выходных токенов, чем Qwen, но в 2,8 раза меньше вычислений по оценочной методике сервиса.
Модель поддерживает контекст до миллиона токенов, принимает текст и изображения, а выдаёт текст. Для локального запуска заявлены Transformers, llama.cpp, MLX и vLLM. Веса распространяются по Apache 2.0, поэтому разработчики могут изучать, дообучать и встраивать модель в свои продукты. Для пользователей в России это даёт возможность тестировать модель на собственном оборудовании без обращения к закрытому зарубежному API.
Одновременно вышла исследовательская версия с настраиваемым числом проходов. Один или два прохода ускоряют генерацию, но могут снизить качество; Hugging Face предупреждает, что этот режим пока не прошёл углублённую оценку. Релиз продолжает линейку Inkling: 12 ноября Thinking Machines открыла веса более крупной Inkling 2 Small.