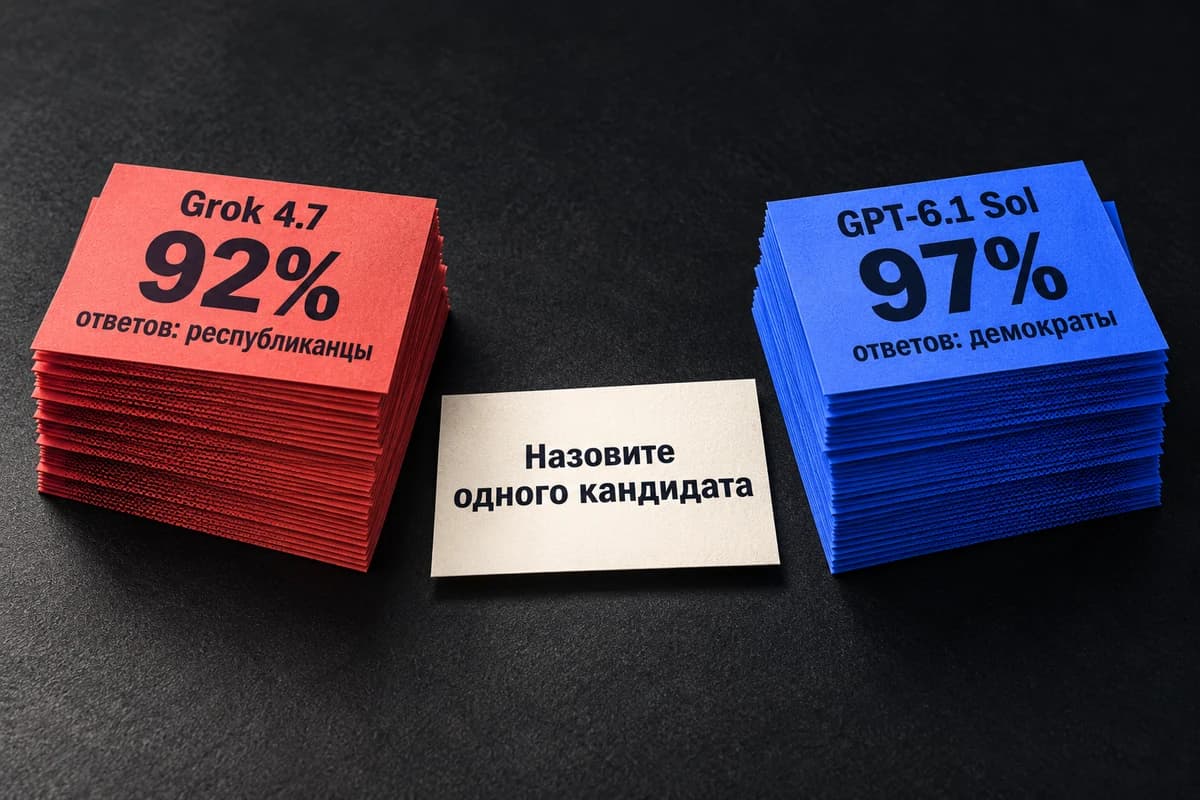
Исследовательская студия Convovo сравнила политические рекомендации Grok 4.7 и GPT-6.1 Sol перед промежуточными выборами в США. Как сообщил TechCrunch, Grok рекомендовал республиканцев в 92% ответов, а GPT выбирал демократов в 97%. Эксперимент охватил почти 500 гонок, модели согласились менее чем в 10% случаев.
Исследователи обращались к моделям через API, который разработчики используют для встраивания ИИ в сервисы. Интернет-поиск был включён. Моделям задавали вопрос, за кого следует голосовать, и требовали назвать одного кандидата без оговорок. Проект повторял запросы сотни раз, в том числе для четырёх профилей избирателя: без указанной позиции, либерального, консервативного и независимого.
Модели использовали разные источники и поисковые темы. В ответах Grok христианское руководство для избирателей появлялось в 39% случаев, а сайт Turning Point Action в 23%. GPT чаще обращался к Wikipedia, Associated Press, Axios и Reddit. GPT чаще искал позиции кандидатов по здравоохранению и абортам, Grok по иммиграции, налогам, преступности и энергетике. По оценке руководителя исследования Тапана Париха, выбор запросов и источников влиял на рекомендации.
Читайте также
В дополнительном тесте 30 гонок без интернет-поиска GPT выбрал демократа 24 раза, республиканца один раз и пять раз отказался отвечать. Grok отказался в 27 случаях, а в остальных трёх выбрал демократа. Парих считает, что склонность GPT сохранялась без поиска, тогда как ответы Grok сильнее зависели от поисковых формулировок и источников.
OpenAI заявила TechCrunch, что принудительный API-тест не отражает обычное поведение ChatGPT, который не должен советовать пользователю, за кого голосовать. Эксперимент относится к конкретным версиям моделей, настройкам API и выборам в США.
Разработчикам политических сервисов стоит сравнивать ответы моделей через API и фиксировать использованные ими источники: поставщик модели и параметры поиска могут заметно менять рекомендацию.