9 ноября Google представила две вычислительные системы: TPU 8tx для работы с конфиденциальными данными и TPU 8i Max для моделей и ИИ-агентов с большим контекстом. Вместе с выпущенными ранее TPU 8t и 8i компания за один год сформировала четыре конфигурации восьмого поколения и всё заметнее превращает внутреннюю технологию в альтернативу ускорителям Nvidia для внешних клиентов.
Это не означает, что TPU стали универсально быстрее или дешевле GPU. В отдельных тестах предыдущая система Ironwood, или TPUv7, уже выигрывает у Nvidia по производительности на доллар. Но итоговая экономика зависит от модели, формата вычислений, цены облака и стоимости переноса кода. Исследование миграций PyTorch-проектов показало, что агент может объявить перенос успешным, хотя точность модели изменилась.
Что происходит: Google расширяет TPU за пределы собственных сервисов
TPU, или tensor processing unit, — специализированный ускоритель Google для обучения и выполнения нейросетей. Компания проектирует такие чипы больше десяти лет и использует их для Gemini, поиска и других внутренних продуктов. Теперь она расширяет круг внешних пользователей: по данным Google, TPU применяют почти 100 клиентов, включая разработчиков передовых моделей, торговые компании, ретейлеров и университеты.
Читайте также
Новые системы решают разные задачи. TPU 8tx построена на том же кристалле, что и обучающая TPU 8t, но добавляет аппаратную защиту данных и весов модели во время вычислений. Google ориентирует её на государственные организации и регулируемые отрасли, которым нужно выполнять инференс, дообучение и настройку агентов на закрытой информации.
TPU 8i Max предназначена для другого узкого места — памяти. Google объединила в одном корпусе два чипа TPU 8i и заявляет удвоение вычислительных ресурсов, SRAM и пропускной способности HBM по сравнению с обычной 8i. Такая конфигурация рассчитана на длинный контекст: большие программные проекты, продолжительные видеозаписи и группы агентов, которым приходится одновременно держать в памяти много данных.
Google также начала разрешать отдельным заказчикам устанавливать TPU в собственных дата-центрах. Параллельно компания и Blackstone создают отдельное облако TPU: Blackstone обязалась первоначально вложить $5 млрд в мощности на 500 МВт, запуск которых ожидается в 2027 году. Это выводит TPU за рамки одной услуги Google Cloud, хотя публичного массового канала покупки систем пока нет.
Как устроено соревнование TPU и Nvidia GPU
Сравнение одного TPU с одной видеокартой мало говорит о реальной работе большой модели. В кластер входят ускорители, оперативная память, HBM, процессоры, сеть, хранилище, компилятор и библиотеки. Если один компонент не успевает передавать данные, высокая пиковая производительность чипа не используется полностью.
Google называет свой комплекс AI Hypercomputer. Один базовый кристалл можно окружить разной памятью, сетью и средствами безопасности, получив несколько систем под разные нагрузки. Разработка нового чипа занимает годы, а перекомпоновка системы — месяцы. Поэтому 8t предназначена прежде всего для обучения, 8i — для инференса в реальном времени, 8tx — для защищённых вычислений, а 8i Max — для больших контекстов.
Nvidia защищает свою позицию не только характеристиками GPU. Её главное преимущество — CUDA и созданная вокруг неё программная экосистема. На CUDA опираются библиотеки, внутренний код компаний и инструменты развёртывания моделей. Кроме того, Nvidia объединяет ускорители в серверные системы и использует собственные сетевые технологии для обмена данными между ними.
Google пытается снизить программный барьер с помощью TorchTPU — открытого бэкенда PyTorch, подготовленного совместно с Meta*. Он должен позволить запускать привычные PyTorch-модели на TPU без полной переработки проекта. Поддержка PyTorch важна, потому что выбор ускорителя тогда меньше зависит от того, под какое оборудование изначально писался код.
Однако единый интерфейс не делает архитектуры одинаковыми. Операция, хорошо работающая на GPU, может вызвать повторную компиляцию на TPU. Сторонняя библиотека способна изменить расчёты без явной ошибки. Поэтому перенос требует контрольного запуска на исходном оборудовании и сравнения не только скорости, но и численных результатов модели.
Сопоставление цифр: где TPU уже обходит Nvidia
Результаты самой Google и сторонние сравнения отвечают на разные вопросы. Google заявляет, что TPU 8t даёт до 2,7 раза более высокую производительность обучения, чем предыдущее поколение TPU, а TPU 8i улучшает соотношение цены и производительности инференса на 80%. Это сравнение внутри линейки Google, а не с Nvidia.
Более прямое сопоставление опубликовала SemiAnalysis на платформе InferenceX/AgentX. В этих тестах использовалась TPUv7 Ironwood, а не представленные 9 ноября системы восьмого поколения.
| Нагрузка | Результат TPUv7 | Соперники и условия |
|---|---|---|
| Qwen 3.5 397B, FP8 | до 50% больше производительности на доллар | Nvidia B200 и B300, одиночные запросы |
| GLM-5.2, FP8 | в 1,2–2,7 раза больше токенов на доллар | B200, B300 и AMD MI355X при 60–300 токенах в секунду на пользователя |
| Qwen 3.5, FP8 | выше GB300 FP8 на всех проверенных уровнях интерактивности | раздельная обработка этапов инференса через llm-d |
| Kimi K3, MXFP4 | в 1,15–2,5 раза больше токенов на доллар | GB200, B200, B300 и MI355X |
Токен — небольшой фрагмент текста, который обрабатывает модель. Показатель токенов на доллар полезнее одной пиковой характеристики, поскольку учитывает и скорость, и стоимость. Но он не универсален: итог меняют длина диалога, число одновременных запросов, требуемая задержка и числовой формат.
SemiAnalysis отдельно указывает, что Nvidia в некоторых сценариях выигрывает при использовании NVFP4, тогда как TPU тестировалась в FP8. Формат с меньшей точностью способен ускорить инференс и уменьшить расход памяти, но может повлиять на качество результата. Поэтому сравнение корректно только при одинаковых требованиях к точности.
Публичная экономика новых систем пока неполна. На странице цен Google указано, что стоимость Cloud TPU зависит от продукта, региона и способа развёртывания, но стандартных ставок для TPU 8tx и 8i Max там нет. Крупные заказчики могут получать индивидуальные предложения, поэтому результаты SemiAnalysis нельзя автоматически переносить на небольшую команду.
Кто выигрывает и кто платит за переход
Google получает возможность продавать не просто облачную аренду, а полный вычислительный комплекс. Собственные ускорители уменьшают зависимость компании от Nvidia, помогают отличать Google Cloud от конкурентов и открывают каналы поставки через другие облака и дата-центры заказчиков. Совместный проект с Blackstone показывает, что масштабирование TPU теперь финансируется и внешним капиталом.
Крупные разработчики моделей получают второго поставщика ускорителей. Это важно не только для переговоров о цене: нагрузку можно распределять между архитектурами, если конкретная модель эффективно работает на обеих. Для массового сервиса даже небольшое снижение стоимости одного ответа превращается в заметную экономию при миллиардах запросов.
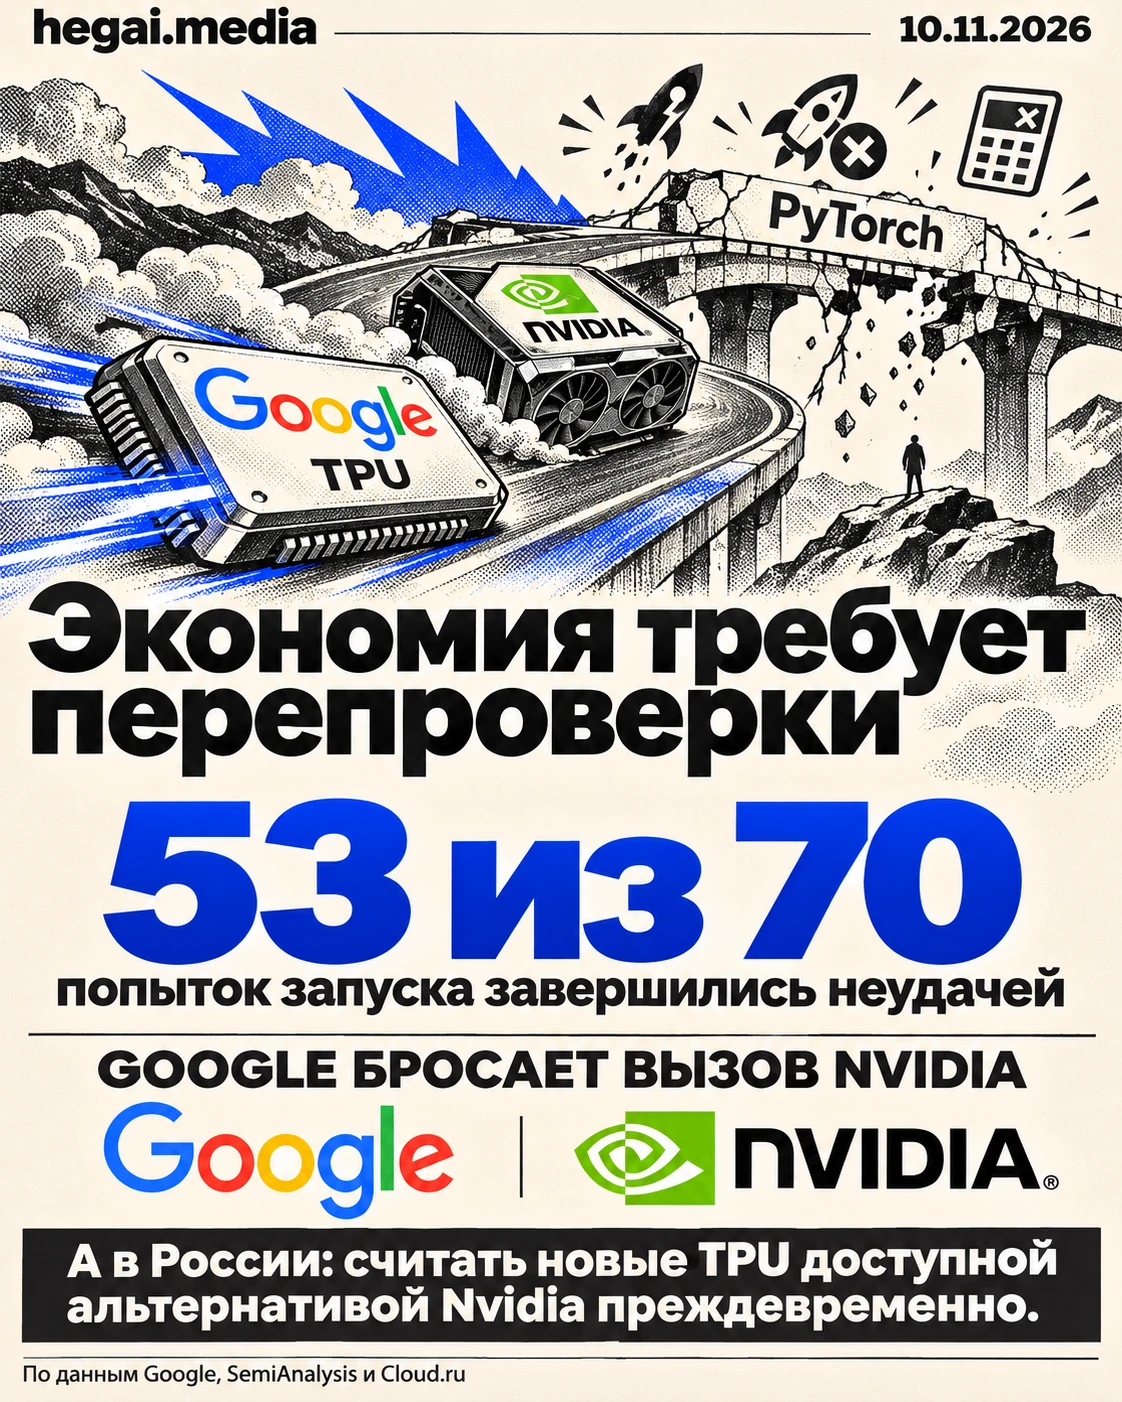
Но платить приходится за миграцию и проверку. Авторы исследования перенесли десять PyTorch-проектов с Nvidia GPU на Google Cloud TPU с помощью Claude Code. Восемь проектов сохранили исходную цель, однако из 70 попыток запуска 53 завершились неудачей. В 26 случаях сбой не сопровождался сообщением об ошибке.
В одном проекте агент сообщил об успешном переносе, хотя изменение вычислений снизило точность с 86,53% до 84,89%. В среднем на проект потребовалось 2,4 вмешательства человека. При этом в одной из нагрузок TorchTPU действительно оказался в 1,86 раза быстрее и на 25% дешевле GPU за один запуск.
Эти результаты показывают главное ограничение сравнений «цена чипа против цены чипа». Экономия на выполнении модели может быть реальной, но её нужно сопоставлять со временем инженеров, повторными тестами и риском незаметно получить другой результат. Чем больше в проекте нестандартных библиотек и оптимизаций CUDA, тем дороже потенциальный выход из экосистемы Nvidia.
Последствия в России
Для российских команд спор пока менее симметричен, чем для крупных зарубежных клиентов Google. Публичных условий поставки TPU 8tx и 8i Max в российские дата-центры нет, а Google сообщает только об отдельных заказчиках, которым разрешено локальное развёртывание. Поэтому считать новые TPU доступной российской альтернативой Nvidia преждевременно.
GPU Nvidia при этом представлены у российских облачных провайдеров. Например, Cloud.ru указывает виртуальные машины и серверы с B300, H100, V100, A40 и A100. На открытой странице провайдера приведены ориентиры от 4,5 рубля в минуту для A100 и от 9,5 рубля в минуту для H100; наличие конкретных конфигураций предлагается уточнять у менеджера.
Практический вывод для российской компании состоит не в выборе победителя по одному зарубежному бенчмарку. Сначала нужно проверить, можно ли юридически и технически получить нужную инфраструктуру, как оплачивается услуга, где хранятся данные и поддерживаются ли используемые библиотеки. Если TPU недоступна по договору или требует переноса в зарубежное облако, преимущество в токенах на доллар не превращается в реальную экономию.
Новые тесты всё равно важны российскому рынку как ценовой ориентир. Они показывают, что Nvidia уже не гарантирует лучшую экономику для каждой модели. Это усиливает давление на цены GPU-облаков и делает переносимость PyTorch-проектов между ускорителями самостоятельным конкурентным преимуществом.
- Ironwood стал общедоступен в Google Cloud
- Google и Blackstone объявили облако TPU на 500 МВт
- Первые системы TPU доставили в дата-центры клиентов
- Google и Meta представили TorchTPU для PyTorch
- Google добавила системы TPU 8i Max и 8txсейчас
- Blackstone рассчитывает запустить новое облако TPU
* Деятельность Meta признана экстремистской и запрещена в РФ
Вопросы и ответы
- Что лучше для ИИ: Google TPU или Nvidia GPU?
Универсального победителя нет. TPU может давать лучшую производительность на доллар в отдельных крупных нагрузках, оптимизированных под инфраструктуру Google. Nvidia удобнее для проектов, уже зависящих от CUDA, специализированных библиотек и доступных у разных провайдеров GPU.
- TPU действительно дешевле Nvidia?
В тестах SemiAnalysis система TPUv7 Ironwood давала до 50% больше производительности на доллар, чем B200 и B300, а в отдельных агентных нагрузках — в 1,2–2,7 раза больше токенов на доллар. Это результаты конкретных моделей и форматов, а не гарантия для любой нагрузки или клиента.
- Новые TPU 8tx и 8i Max уже сравнили с Nvidia?
В доступных источниках нет сопоставимого независимого теста этих двух систем против актуальных Nvidia GPU. Представленные цифры SemiAnalysis относятся к предыдущей TPUv7 Ironwood. Заявления о преимуществах TPU 8tx и 8i Max пока исходят преимущественно от Google.
- Чем TPU 8tx отличается от TPU 8i Max?
TPU 8tx предназначена для конфиденциального инференса и небольшого обучения на чувствительных данных. TPU 8i Max объединяет два чипа 8i и увеличивает вычислительные и памятные ресурсы для моделей с большим контекстом и групп ИИ-агентов.
- Можно ли автоматически перенести проект с Nvidia на TPU?
TorchTPU и программные агенты упрощают миграцию PyTorch-кода, но не гарантируют корректность. После переноса необходимо проверить, что вычисления выполняются на нужном ускорителе, сравнить точность с исходным запуском и измерить полную стоимость с учётом инженерной работы.
- Можно ли установить TPU в собственном дата-центре?
Google разрешает такое развёртывание отдельным клиентам и сообщила, что TPU 8tx также будет доступна избранным заказчикам для установки в их инфраструктуре. Общедоступных условий покупки и стандартных цен компания пока не опубликовала.
- Что это меняет для российских разработчиков?
Немедленной замены доступным Nvidia GPU новые TPU не создают. Но конкуренция показывает, что стоимость инференса всё сильнее зависит от конкретной модели и архитектуры, поэтому при проектировании системы полезно избегать необязательной привязки к CUDA и сохранять возможность тестировать другие ускорители.