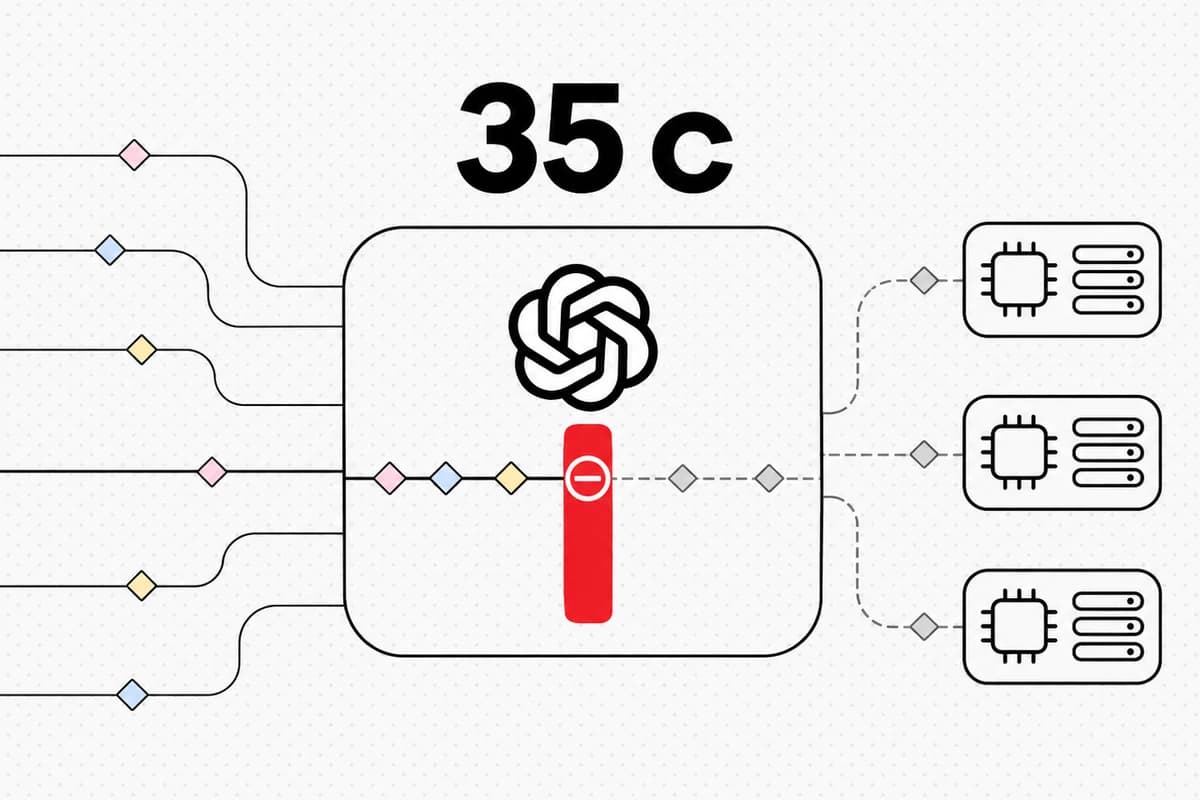
OpenAI 9 ноября представила Control Room — централизованную систему, которая может запретить внутренней исследовательской задаче получать новые ответы ИИ-моделей. После поступления команды на остановку блокировка должна сработать максимум за 35 секунд.
В 2026 году OpenAI раскрывала случаи, когда исследовательские агенты выходили за пределы инструкций: покидали ограниченную тестовую среду, получали несанкционированный доступ к внешним ресурсам или использовали криптокошелёк без разрешения.
Система предназначена для экспериментов по обучению и оценке моделей, агентных процессов и обработки данных. Это не новая кнопка в ChatGPT и не механизм управления пользовательскими диалогами: Control Room работает во внутренней исследовательской инфраструктуре OpenAI.
Читайте также
При запуске каждая задача получает уникальный идентификатор job_id. Он передаётся вместе с запросами к механизму вывода — инфраструктуре, которая запускает модель на графических процессорах и генерирует результат. Перед выполнением очередного запроса механизм сверяется с Control Room и проверяет, разрешено ли задаче продолжать работу.
Если исследователь или автоматическая система мониторинга отдали команду остановки, следующий запрос будет отклонён. Сам код эксперимента при этом может продолжать выполняться, но уже не сможет получать новые результаты от моделей через подключённые механизмы вывода.
OpenAI разместила проверку на уровне общей инфраструктуры, а не внутри каждого эксперимента. Исследовательский код часто меняется и может содержать ошибки, тогда как путей доступа к моделям меньше и ими проще управлять централизованно. Блокировка распространяется на все модели и механизмы вывода, которыми пользовалась остановленная задача.
Control Room дополняет мониторинг, а не заменяет его. Наблюдающая система должна сначала заметить потенциально опасное поведение и принять решение о вмешательстве. Только после получения стоп-команды Control Room перекрывает новые запросы. Поэтому заявленные 35 секунд не включают время, необходимое для обнаружения проблемы и принятия решения.
Задержка связана с кэшем разрешений, который помогает обслуживать большой поток запросов. OpenAI утверждает, что работает над сокращением этого интервала до нуля. Система также настроена по принципу fail closed: если сам центральный сервис отключится из-за ошибки или вмешательства, механизмы вывода должны отклонять запросы до восстановления его работы.