ИИ-агенты в кибербезопасности анализируют репозиторий, проверяют возможный путь атаки, пытаются воспроизвести уязвимость и предлагают патч. Свежий пример появился 11 ноября 2026 года: проект Apache выпустил HTTP Server 2.4.71 с исправлением критической уязвимости, среди обнаруживших которую указан сканер Anthropic.
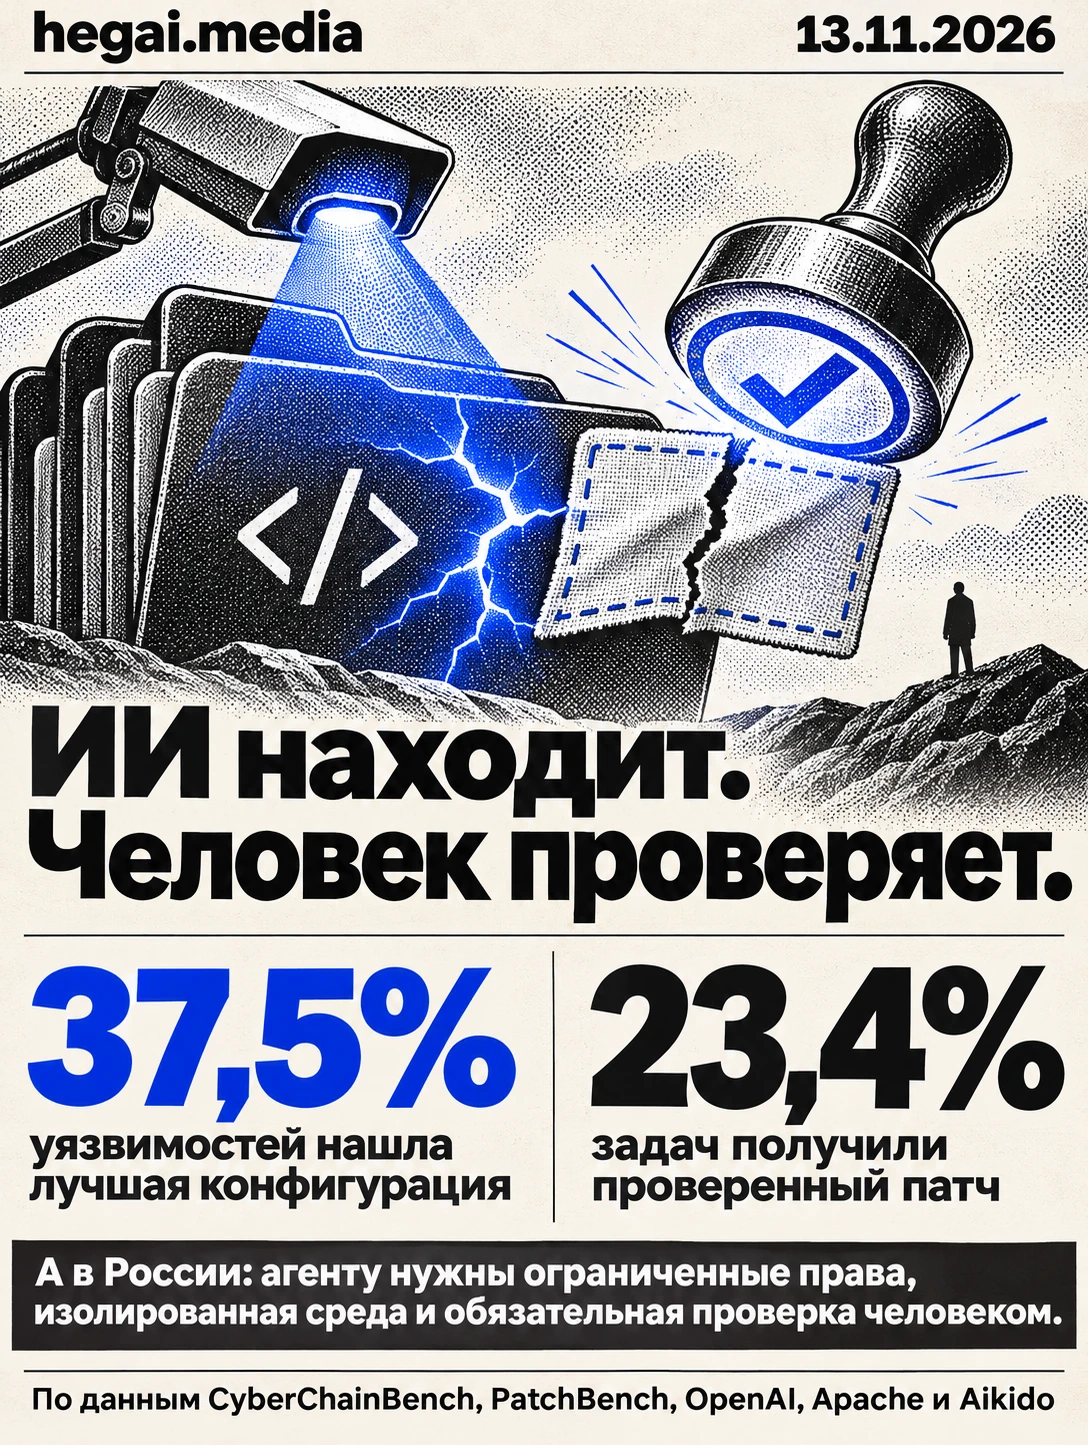
Однако поиск ошибки и надежное исправление — разные задачи. В испытании CyberChainBench лучшая конфигурация обнаружила 37,5% уязвимостей, воспроизвела атаку в 43,7% случаев, а проверенный патч подготовила только в 23,4%. ИИ может ускорить часть работы, но для этого ему нужны ограниченные права и обязательная проверка человеком.
Что изменилось в поиске уязвимостей
Агент может собрать контекст из нескольких файлов, изучить зависимости и конфигурацию, сформулировать гипотезу, запустить инструменты и изменить план после неудачного теста.
Читайте также
В марте 2026 года OpenAI открыла предварительный доступ к Codex Security. По описанию компании, система анализирует устройство репозитория, выделяет доверенные компоненты и внешние точки входа, а затем оценивает возможные проблемы по их практическому эффекту и предлагает исправления.
К июню возможности продукта расширились: Codex Security получил инструменты для сканирования всей кодовой базы, построения модели угроз, прослеживания пути атаки, проверки находок и подготовки патчей. По данным OpenAI, к тому моменту сервис обработал более 30 млн изменений кода в 30 000 репозиториев. Люди подтвердили свыше 70 000 исправлений, еще 500 000 находок были закрыты автоматически.
OpenAI также запустила программу Patch the Planet вместе с Trail of Bits и при участии HackerOne и Calif. Исследователи с ИИ-инструментами проверяют отчеты, удаляют дубликаты и готовят патчи до передачи сопровождающим проектов. К программе присоединились более 30 проектов, включая cURL, Go, Python, Sigstore и pyca/cryptography.
Это меняет прежде всего масштаб работы. Один агент может повторять похожий процесс на множестве репозиториев, а небольшая команда получает предварительно проверенные находки вместо необработанного потока предупреждений. Ответственность за границы проверки и принятие изменений при этом остается у людей.
Как агент доказывает, что ошибка опасна
Работа начинается с контекста: соседних компонентов, зависимостей, конфигурации, границ доверия и данных, которые приложение должно защищать. На их основе агент строит модель угроз и ищет путь от внешнего ввода к потенциально опасной операции.
Затем он проверяет, достижим ли этот путь в конкретной конфигурации. Одинаковая ошибка может не иметь внешнего входа в одном приложении и позволять атаку в другом. Поэтому полезный отчет должен содержать не только подозрительную строку кода, но и сценарий воспроизведения, условия эксплуатации и доказательства того, что путь действительно работает.
В CyberChainBench этот процесс проверяли на 541 реальном инциденте со смарт-контрактами в девяти блокчейн-сетях. Агентам давали изолированные копии исторического состояния блокчейнов. Они могли читать код, прослеживать транзакции и воспроизводить атаки, не затрагивая действующие сети.
Патч считался успешным, если прежняя атака переставала работать, а обычные транзакции сохранялись. Такой подход важен и за пределами блокчейнов: исправление должно блокировать уязвимый путь, не ломая легитимное поведение программы.
Почему найти уязвимость проще, чем написать патч
CyberChainBench показывает заметный разрыв между отдельными этапами. Лучшая конфигурация нашла 37,5% уязвимостей и успешно воспроизвела атаку в 43,7% случаев, но прошедшее проверку исправление подготовила только для 23,4% задач.
Эксперимент одновременно показывает двойное назначение технологии. Codex с GPT-5.5 в изолированных исторических копиях блокчейнов воспроизвел атаки с суммарным экономическим эффектом $57,4 млн на наборе из 200 случаев. Средняя стоимость запуска составила $2,39 на случай. Это лабораторный результат, а не реально похищенные деньги, но он показывает, насколько дешевой может стать автоматизированная проверка гипотез об атаке.
Другое исследование, PatchBench, выявило два источника завышенных результатов. В среднем 25% патчей агентов существенно походили на исторические исправления разработчиков: модель могла воспроизводить решение, встречавшееся в обучающих данных. Кроме того, агент иногда устранял видимое падение программы, не находя первопричину.
Проверка только на исходном примере атаки завышала долю решенных задач в среднем в 1,83 раза. Патч мог распознать конкретный вход или подавить сбой в месте его проявления, оставив саму уязвимость. Поэтому нужны новые тестовые данные, проверка обычных сценариев и тесты, которых агент заранее не видел.
Что показал свежий случай с Apache
11 ноября Apache выпустил HTTP Server 2.4.71. В нем исправлена критическая уязвимость CVE-2026-119618 в модуле HTTP/2: ненадлежащая синхронизация при совместном использовании ресурса могла привести к повреждению кучи и удаленному выполнению кода.
Проблема затрагивала Apache HTTP Server версий с 2.4.55 по 2.4.70. На официальной странице проекта среди обнаруживших ошибку указаны Anthropic OSS Scanner, а также исследователи Энтони Уимс и Саймон Скэннелл из Google Cloud Vulnerability Research.
Этот пример важен не как доказательство полной автономности ИИ. Публичная запись Apache подтверждает вклад сканера в обнаружение конкретной критической ошибки, но не показывает, какую долю исследования и подготовки исправления выполнила система без участия людей. Зато случай демонстрирует практический результат: автоматизированный поиск уже помогает находить уязвимости в массовом серверном ПО, а не только решать специально подготовленные тесты.
Кто выигрывает и кто платит за автоматизацию
Больше всего выигрывают команды, у которых объем кода и входящих отчетов превышает возможности специалистов по безопасности. Агент способен предварительно разбирать находки, убирать дубликаты, проверять достижимость ошибки и готовить изменение для просмотра инженером.
Цена такого ускорения — доступ. Для полноценной работы системе может понадобиться читать закрытый репозиторий, запускать сборку, создавать ветки и обращаться к тестовой инфраструктуре. Если эти полномочия скомпрометированы, радиус ущерба определяется не интеллектом агента, а доступными ему секретами и действиями.
Масштаб риска показала кампания wfx-loot, обнаруженная исследователями Aikido. 10 ноября атакующий использовал учетные данные 4837 скомпрометированных аккаунтов GitHub, чтобы проверить права на запись в 61 764 репозитория. Вредоносные процессы GitHub Actions похитили секреты как минимум у 1835 целей.
Скрипт собирал токены GitHub, временные ключи AWS, Azure и Google Cloud, учетные данные Docker, Kubernetes, npm, PyPI, Vault и Terraform, а также ключи сервисов OpenAI, Anthropic, Gemini, Cursor и GitHub Copilot. Около 50 скомпрометированных аккаунтов имели права публикации в других экосистемах открытого ПО.
Это не была атака защитного ИИ. Но она показывает, что произойдет, если автоматизированный процесс внутри репозитория получит лишние полномочия или будет подменен: одной операции сборки может оказаться достаточно для доступа к облакам, пакетным реестрам и рабочей инфраструктуре.
Последствия в России
Расширенные киберинструменты OpenAI доступны только проверенным специалистам по защите, а Codex Security Review — пользователям тарифов ChatGPT Enterprise, Business, Edu и Pro. Доступность этих возможностей в России пока неизвестна. При работе с защитным агентом ему следует выдавать права привилегированного инструмента разработки.
Ему нужна отдельная сервисная учетная запись с доступом только к необходимым репозиториям и действиям. Возможность самостоятельно объединять изменения с основной веткой лучше исключить, а постоянные ключи заменить короткоживущими токенами. Среда проверки не должна автоматически наследовать секреты облака, реестра пакетов и производственной инфраструктуры.
Для критичных систем патч должен пройти обычный просмотр кода человеком. Инженеру нужны доказательство достижимости проблемы, воспроизводимый сценарий атаки, тест против исходной уязвимости и регрессионные тесты нормальной работы. Иначе скорость агента превращается в скорость распространения неправильного исправления.
Командам, использующим собственные или открытые модели, одной модели недостаточно. Потребуется изолированная среда, где можно безопасно собирать код, воспроизводить атаку и проверять патч. Сравнивать такие решения следует на задачах конкретного репозитория, а не по общим возможностям модели программировать.
Вопросы и ответы
- Как ИИ находит уязвимости в коде?
Агент читает репозиторий, зависимости и конфигурацию, строит путь от внешнего ввода к опасной операции и пытается воспроизвести проблему в изолированной среде. Полезный результат включает условия эксплуатации и доказательства достижимости ошибки, а не только подозрительную строку.
- Может ли ИИ сам написать безопасный патч?
Он может предложить изменение и запустить тесты, но безопасность результата не гарантирована. В CyberChainBench лучшая конфигурация подготовила прошедший проверку патч только в 23,4% случаев, а PatchBench показал, что простая проверка одним примером завышает результат в среднем в 1,83 раза.
- Чем агент отличается от статического анализатора?
Агент способен собирать контекст из нескольких файлов, пользоваться инструментами, менять гипотезу, воспроизводить атаку и готовить исправление, но ради этого ему требуется больше доступа.
- Доказал ли случай Apache, что ИИ может автономно исправлять серверы?
Нет. Apache подтверждает, что Anthropic OSS Scanner был среди обнаруживших критическую уязвимость. Публичная запись не устанавливает, что агент самостоятельно провел все исследование или подготовил итоговый патч.
- Почему агенту опасно давать доступ ко всему репозиторию?
Система сборки может содержать токены, облачные ключи и права публикации пакетов. Кампания wfx-loot похитила секреты как минимум у 1835 целей через скомпрометированные аккаунты GitHub и вредоносные процессы сборки, поэтому лишние права увеличивают возможный ущерб.
- Нужно ли принимать предложенные ИИ патчи автоматически?
Нет. Исправление следует проверять просмотром кода, повторением исходной атаки и регрессионными тестами. Автоматическое принятие особенно рискованно для критичных систем и репозиториев, связанных с рабочей инфраструктурой.